
Punkt wyjścia: dużo pracy, zero kontroli
Serwer obsługiwał ponad 100 baz różnych klientów. Plan utrzymania wyglądał solidnie. W niedzielę przebudowywał wszystkie indeksy na wszystkich bazach, bez względu na ich stan, co trwało 1 h 51 min. W sobotę przeliczał wszystkie statystyki z pełnym skanem, co zajmowało kolejne 1 h 26 min.
Zabrakło w nim kontroli spójności. Polecenia DBCC CHECKDB nie było w żadnym zadaniu. Silnik pokazywał, że ostatnie udane sprawdzenie większości baz odbyło się ponad dwa lata wcześniej, a jednej z nich ponad dziesięć lat temu.
To ważne, bo bez kontroli spójności uszkodzenie strony danych może leżeć w bazie niezauważone przez miesiące. Kopie zapasowe powstają codziennie i przechodzą weryfikację, tyle że razem z uszkodzeniem. Kiedy ktoś w końcu trafi na błąd, może się okazać, że żadna z trzymanych kopii nie jest czysta.
Dlaczego przebudowa wszystkiego nie miała sensu
Zanim cokolwiek zmieniliśmy, zmierzyliśmy stan indeksów. Fragmentacja była praktycznie zerowa: najgorszy indeks miał 4,5%, reszta poniżej 0,2%. Cotygodniowa przebudowa nie naprawiała więc niczego, bo nie było czego naprawiać.
Próbne uruchomienie nowego mechanizmu, bez wykonywania operacji, zaplanowało w całej instancji 1 przebudowę i 14 reorganizacji. Stary plan wykonywał ich co tydzień kilkanaście tysięcy.
Pełna przebudowa miała też koszt, którego nikt się nie spodziewał. REBUILD tworzy nową kopię indeksu obok starej. Przy największym indeksie, około 30 GB, każdy przebieg dokładał do pliku bazy mniej więcej 1,4 GB, a dysk z danymi tracił około 1,3 GB wolnego miejsca na dobę. Po zmianie ten indeks kwalifikuje się do REORGANIZE, które działa w miejscu. Pomiar po pierwszym przebiegu pokazał zerowy przyrost pliku.
Co wdrożyliśmy
Oparliśmy się na darmowym i szeroko stosowanym zestawie skryptów Ola Hallengren Maintenance Solution. Zamiast jedenastu domyślnych zadań uruchomiliśmy tylko dwa, dopasowane do tego serwera.
- Kontrola spójności wszystkich baz codziennie o 1:00, pełne
CHECKDB, około 41 minut. - Warunkowe utrzymanie indeksów codziennie o 3:00, około 11 minut. Indeks jest reorganizowany dopiero powyżej 5% fragmentacji, a przebudowywany powyżej 30%. Statystyki są przeliczane tylko tam, gdzie dane się zmieniły.
- Powiadomienia o błędach dla wszystkich aktywnych zadań. Wcześniej miało je 13 z 20.
- Dziennik operacji, w którym każdy krok zapisuje się z czasem trwania i kodem błędu. Gdy coś pójdzie nie tak, widać, na której bazie i na którym indeksie.
Wyłączyliśmy też dwa osobne plany reindeksacji, które dublowały pracę planu głównego. Zostały zachowane, nie usunięte.
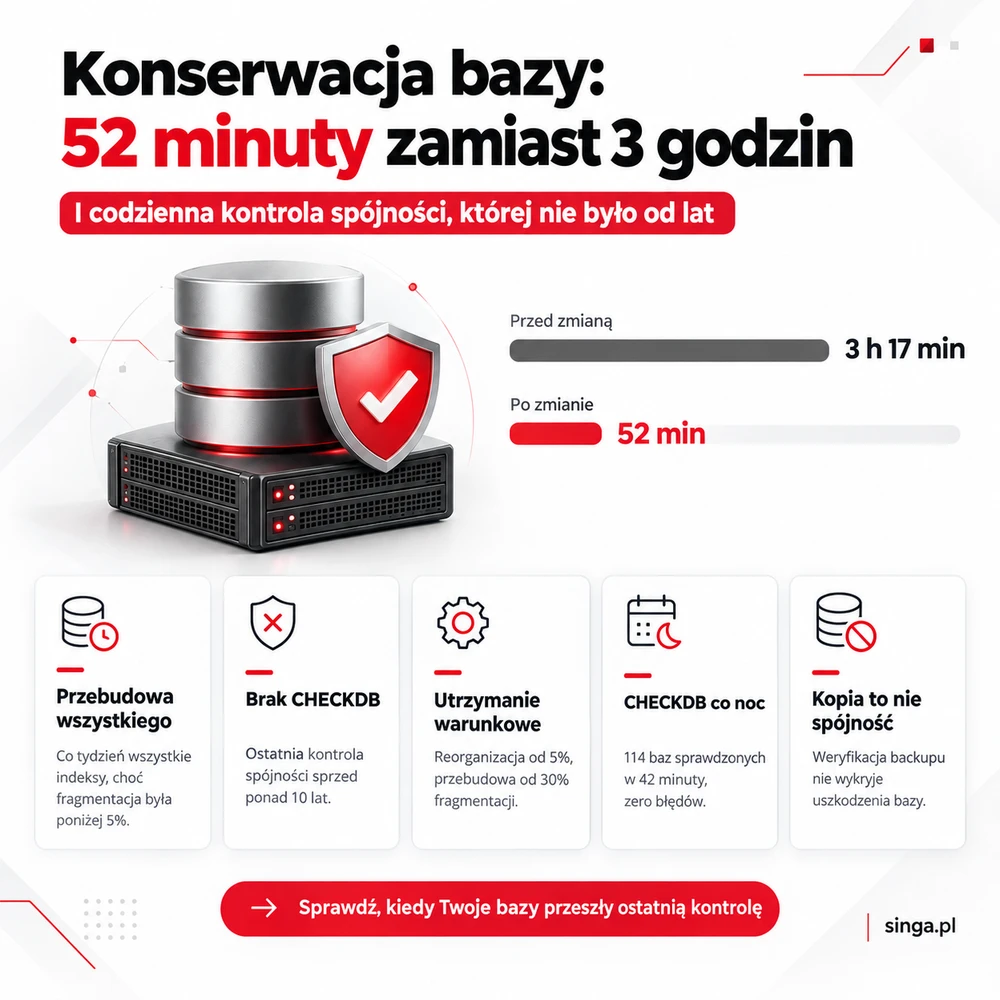
Efekt: 52 minuty zamiast 3 godzin 17 minut
Nocne utrzymanie skróciło się z 3 h 17 min do około 52 min, a przy tym robi więcej niż wcześniej, bo obejmuje kontrolę spójności, której nie było wcale.
Pierwsze pełne CHECKDB całej instancji trwało 42 minuty i objęło 114 baz. Nie znalazło żadnego błędu, także w bazach niesprawdzanych od kilkunastu lat. Żadna baza nie potrzebowała więcej niż 3,5 minuty. Tym razem skończyło się dobrze, ale teraz wiemy to na pewno i będziemy wiedzieć każdej nocy.
Stary plan miał swój powód
Przy omawianiu zmian wyszło, dlaczego część dodatkowych planów w ogóle powstała. W bazach dwóch klientów indeksy fragmentują się bardzo szybko, a po ich zgłoszeniach wprowadzono codzienną nocną przebudowę.
To dobry przykład, że konfiguracji zastanej nie ocenia się tylko po metrykach. Utrzymanie warunkowe dobrze obsługuje także takie bazy. Działa codziennie i przebudowuje indeks dopiero wtedy, gdy fragmentacja rzeczywiście przekroczy próg. Bazy, które tego potrzebują, dostają obsługę każdej nocy, a pozostałe nie tracą czasu na zbędną pracę.
Kopia z sumą kontrolną to nie to samo co CHECKDB
Na tym serwerze kopie zapasowe były robione poprawnie: każda z opcją WITH CHECKSUM i od razu sprawdzana przez RESTORE VERIFYONLY. Łatwo wtedy uznać, że dane są bezpieczne.
Weryfikacja kopii potwierdza jednak tylko, że plik kopii jest czytelny i zgadza się z tym, co zapisano. Nie sprawdza logicznej spójności bazy. Kopia uszkodzonej bazy przejdzie weryfikację bez zastrzeżeń. Dlatego jedno nie zastępuje drugiego, a CHECKDB powinno być w każdym planie utrzymania.
Jak sprawdzić, czy ten problem dotyczy Twojego serwera
- Sprawdź datę ostatniego udanego
CHECKDBdla każdej bazy. Jeśli jest starsza niż tydzień albo jej nie ma, to pierwszy sygnał. - Zmierz fragmentację indeksów, zanim zdecydujesz, że trzeba je przebudowywać. Przebudowa bez progów to zwykle stracony czas i miejsce na dysku.
- Porównaj czas trwania zadań konserwacji z oknem serwisowym. Plan, który rośnie razem z bazami, w końcu zacznie nachodzić na godziny pracy.
- Upewnij się, że każde zadanie powiadamia kogoś o błędzie. Zadanie, które cicho przestało działać, jest gorsze niż jego brak, bo daje fałszywe poczucie bezpieczeństwa.
Porozmawiajmy o Twojej bazie
Jeśli nie wiesz, kiedy Twoje bazy ostatnio przeszły kontrolę spójności albo co robi co noc plan konserwacji, przejrzymy to razem w ramach administracji serwerami. Zaczynamy od pomiaru stanu bazy, a zmiany proponujemy dopiero na podstawie liczb.
Umów rozmowę o Twoim serwerze